Тестирование рекламы с ИИ: прогноз Jev против реальных результатов VK
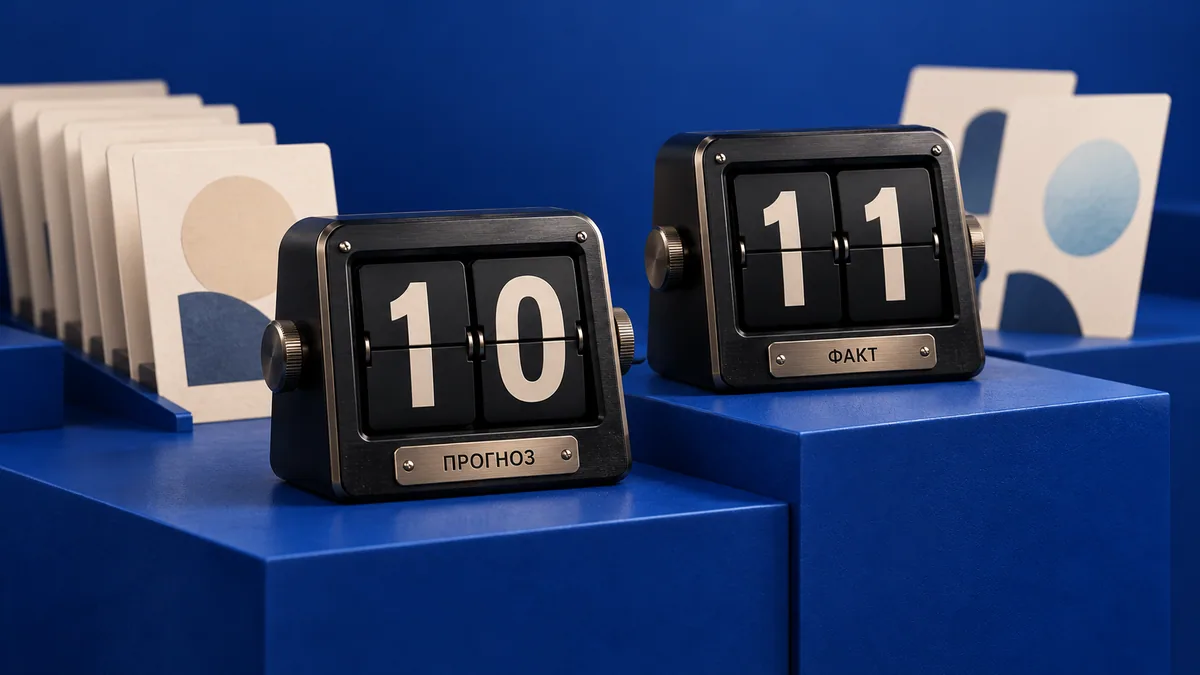
Коротко. Тестирование рекламы с ИИ можно начать с предварительного отбора: сравнить материалы и выбрать, что первым проверить на трафике. В эксперименте Dsrupt ранний расчёт с Jev дал около 10 заявок по 991 ₽, а в выгрузке оказалось 11 по 960 ₽. Но прогноз без фактической статистики — ещё не подтверждённый тест до запуска: сохранённые V2/V3 датированы 21 октября для периода 20–21 октября. Ниже — результаты, ошибки и ограничения этого опыта.
Содержание статьи
- Что именно проверяли: отбор креативов и прогноз — разные задачи
- Как устроено тестирование рекламы с ИИ
- Прогноз против факта: почему нельзя оставить только красивое попадание
- Где прогноз ошибся сильнее, чем кажется по стоимости заявки
- Угадал ли Jev лучшие объявления
- Что показало сравнение Jev и Opus 5.5
- Можно ли так тестировать рекламу без бюджета
- Как повторить эксперимент без подгонки результата
- Что из этого стоит забрать в работу
Сорок концепций креативов, сорок комплектов текстов и двадцать вариантов лид-формы. Проверять всё на реальных показах дорого. Выбирать только по ощущению — тоже риск: симпатичная картинка не обязана приносить подходящие обращения.
Автор Dsrupt Артём попробовал промежуточный шаг: сначала оценить материалы через Jev, затем отправить выбранные варианты в VK Рекламу и сопоставить прогноз с результатом. Короткая версия истории — в исходном посте Telegram. Здесь — подробный разбор с цифрами, ошибками и методикой для тех, кто запускает рекламу и хочет тратить меньше времени на слабые гипотезы.
Что именно проверяли: отбор креативов и прогноз — разные задачи
В эксперименте было две задачи. Первая — сократить набор материалов до запуска. Вторая — попробовать оценить будущие заявки, их стоимость и показатели воронки. Эти задачи нельзя считать одной: полезный фильтр объявлений ещё не становится точным предсказателем аукциона.
Проект — компания по строительству и продаже домокомплектов. Для подготовки сделали 40 концепций креативов, 40 комплектов рекламных текстов и 20 вариантов лид-формы. Это не сотня независимых кампаний и не несколько сотен проверенных на трафике объявлений: речь о подготовленных элементах и вариантах материалов.
В итоге выбрали пять комплектов объявлений и одну форму. Одни и те же пять объявлений разместили в шести группах с разными аудиториями: 6 × 5 = 30 связок «аудитория + объявление». Поэтому тридцать связок не равны тридцати уникальным креативам. Общие материалы и один рекламный запуск связывают их результаты между собой.
Для прогноза использовали контекст продукта, цены, аудитории, содержание объявлений, лид-форму, бюджет и условия размещения. Фактические клики и отправки формы в прогнозные запросы не передавали. Однако в сохранённых V2/V3 уже задан общий расход 10 000 ₽, а дата файлов — 21 октября для периода 20–21 октября. Это проверка с сокрытой статистикой результата, не подтверждение того, что весь прогноз был сделан до первого показа. Предзапусковой отбор материалов и последующее прогнозирование здесь нужно разделять.
Далее отдельно покажем ранний расчёт, сохранённую версию V3 и более позднее сравнение с Opus — без выбора одной удачной цифры вместо всей истории.
Как устроено тестирование рекламы с ИИ
Jev — модель TypeSafe для структурированных решений. Вместо свободного ответа она возвращает значения в заранее заданном формате: например, выбор варианта или оценку. Такой подход описан в объяснении разработчиков TypeSafe. Это удобно для массовой оценки материалов, но числовой ответ модели сам по себе не является измеренной конверсией покупателей.
Для рекламного отбора важно дать не только текст объявления, но и условия, в которых оно должно работать. Одно и то же обещание по-разному воспринимают человек с участком, покупатель без участка и посетитель, который пока просто собирает идеи. А «домокомплект» и «готовый дом с работами» — разные предложения. Если форма уточняет одно, а объявление обещает другое, проблема начинается до клика.
Практически работу можно разделить на три слоя:
- Контекст и материалы. Что продаём, кому, за какую цену, что входит в предложение и что человек получит после заявки.
- Предварительная оценка. Насколько понятен оффер, подходит ли он ситуации аудитории, совпадает ли обещание с формой, какие вводные отсутствуют.
- Прогнозный расчёт и проверка. Как оценки и допущения переводятся в показы, клики и заявки; насколько результат совпадает с последующей статистикой.
Цифры ниже относятся к конкретной методике и настройкам с использованием Jev. В V3 модель оценивала начальные параметры и неопределённость, а код рассчитывал показы, клики и заявки. Для таблицы был сохранён один согласованный сценарий из 12 000 симуляций, выбранный по заранее заданному правилу. Это не 12 000 независимых рекламных кампаний. Любой запрос к Jev не становится автоматически достоверным прогнозом CPL. Подготовить понятное задание поможет генератор промптов, а проверить обещание — конструктор офферов. Ни один из этих инструментов не заменяет факты о продукте.
Прогноз против факта: почему нельзя оставить только красивое попадание
Ранний расчёт Jev V2 дал математическое ожидание 10,095 заявки при расходе 10 000 ₽. Расчётный CPL — 990,54 ₽. В Telegram это округлено до «около 10 заявок по 991 ₽». Дробная заявка здесь — среднее ожидание модели, не обещание буквального результата.
В согласованном срезе отчёта объявлений получено 11 отправок формы при расходе 10 561,97 ₽. Стоимость одной отправки — 960,18 ₽. Внешне это очень близко к раннему прогнозу. Но позже была зафиксирована и версия V3 с другим сценарием: восемь заявок по 1 250 ₽. Для сравнения с Opus заранее выбрали именно V3, поэтому прятать её за ранним удачным результатом было бы неправильно.
Таблицу можно прокрутить вбок →
| Показатель | Ранний Jev V2 | Jev V3: сохранённый сценарий | Opus 5.5: поздний тест | Факт: отчёт объявлений |
|---|---|---|---|---|
| Расход | 10 000 ₽ | 10 000 ₽ | 10 000 ₽ | 10 561,97 ₽ |
| Заявки | ожидание 10,095 | 8 | 7 | 11 |
| CPL | 990,54 ₽ | 1 250 ₽ | 1 428,57 ₽ | 960,18 ₽ |
| CTR | 0,665% | 0,543% | 0,551% | 0,271% |
| CPC | 22,14 ₽ | 33,22 ₽ | 33,44 ₽ | 42,76 ₽ |
Здесь CPL — расход, разделённый на отправки формы; CPC — расход на клик. Для V2 показано среднее ожидание, для V3 — один зафиксированный сценарий. Это разные статистики, поэтому таблица не является турнирной таблицей точности моделей. Скачать числовую таблицу в CSV можно для самостоятельной проверки расчётов; это сводка, не полная выгрузка кабинета.
Есть и ограничение по периоду. Прогнозный сценарий относился к 20–21 октября 2026 года, а выгрузка охватывала 19–21 октября. Отделить возможный частичный расход первого дня из агрегатов нельзя. Фактический бюджет примерно на 5,62% больше заданного. Поэтому перед нами предварительное сопоставление, а не строгий эксперимент с полностью одинаковыми условиями.
Отдельный поздний снимок кабинета показывал CPL около 1 031 ₽. Это другой срез. В таблице последовательно используется одна выгрузка объявлений с CPL 960,18 ₽; значения из разных снимков не смешаны. Похожая дисциплина нужна и при составлении медиаплана рекламной кампании: одна цифра без периода и определения события мало что объясняет.
Где прогноз ошибся сильнее, чем кажется по стоимости заявки
Если смотреть только на CPL, легко пропустить устройство ошибки. В V3 ожидался CTR около 0,54%, а получился примерно 0,27%. Прогноз предполагал больше кликов при меньшем количестве показов. При этом фактическая доля отправок формы от кликов оказалась выше: 11 / 247 ≈ 4,45% против 8 / 301 ≈ 2,66% в сценарии V3.
Два расхождения частично компенсировали друг друга. На выходе стоимость заявки разошлась не настолько сильно, насколько можно было ожидать по верхней части воронки. Но это не делает верными исходные предположения о кликах и форме.
Ещё одна ошибка — распределение расходов. В четырёх из шести групп одно объявление получило больше 60% бюджета группы. В сохранённом моделировании такая концентрация появлялась заметно реже. На практике кабинет распределял показы и деньги не так, как предполагала методика.
Это важнее, чем спор, «угадал ли ИИ десять вместо одиннадцати». Для рекламодателя полезный прогноз должен помогать выбирать действия: какие связки запускать, где ограничивать расходы и что проверять следующим. Близкая сумма по кампании ещё не гарантирует полезного распределения бюджета внутри неё.
Угадал ли Jev лучшие объявления
Частичное попадание было. В сохранённом сценарии Jev ожидал три заявки у одной связки, которая затем действительно получила три и разделила первое место по их количеству. Именно об этом говорится в посте. Но лидер по количеству и лидер по минимальному CPL — не одно и то же.
Наблюдаемый минимальный CPL получила другая связка: 588,45 ₽ расхода / 3 заявки = 196,15 ₽ за заявку. При этом V3 ожидал в ней ноль. Заранее выбранный лучший вариант V3 тоже не подтвердился: он получил один клик и не дал заявок. По столь малой открутке нельзя заключать, что само объявление плохое.
С «худшим» вариантом ещё сложнее. У 24 из 30 связок в этом срезе не было заявок. Объявление с нулём отправок формы могло быть слабым, могло получить слишком мало показов, а могло не успеть накопить событие. При нуле заявок CPL не определён — он не равен нулю рублей.
Поэтому для следующего теста полезно заранее назвать критерий успеха: больше заявок, ниже CPL при сопоставимом расходе или лучше качество обращений. Без этого после запуска легко найти удобное определение победителя. Принципы проверки небольшой выборки разобраны в материале про значимость A/B-теста.
Что показало сравнение Jev и Opus 5.5
Opus проверили позже, уже после кампании. Для его отдельного запроса использовали подготовленные материалы и условия; фактическую статистику и предыдущие прогнозы в запрос не включали. Сохранился один прогон, а не серия ответов с выбором самого удачного.
Его прогноз — семь заявок по 1 428,57 ₽. По количеству и стоимости заявок он оказался дальше от этой выгрузки, чем основной сценарий Jev V3: восемь по 1 250 ₽. При этом CPC Opus был чуть ближе к факту, а лучшую наблюдаемую связку он не выбрал. Нельзя превращать результат одного показателя в утверждение «одна модель лучше во всём».
Это ретроспективное сравнение с сокрытым результатом, а не одновременное предзапусковое соревнование. Аналитик уже знал факт, даже если модель его не получала. Для более сильной проверки нужны новые кампании и одинаковый заранее зафиксированный протокол для всех участников.
Название Opus 5.5 приведено по журналу этого запуска. Статья не сравнивает все версии моделей, не устанавливает их рыночный рейтинг и не обещает повторения результата на другом продукте.
Можно ли так тестировать рекламу без бюджета
Без расходов на рекламные показы — на этапе предварительного отбора. Без расходов вообще — нет. Нужны время специалиста, подготовка материалов, инструменты и вычисления. А итоговую проверку здесь всё равно проводили на оплаченной рекламе.
В посте упоминаются 100 тысяч рублей, которые могли бы потребоваться на более широкий тест. Это авторская оценка альтернативного сценария, а не измеренная экономия. Не было параллельной кампании, где весь набор протестировали за такую сумму. Поэтому корректный вывод пока звучит так: набор для первичного запуска сократили; сколько денег такой отбор экономит относительно обычной работы специалиста, ещё предстоит проверить.
И предварительное тестирование не обязано быть только машинным. Например, Яндекс Взгляд описывает проверку креативов на целевой аудитории до релиза. Ответы людей, оценка модели и рекламный аукцион — разные виды свидетельств. Одно не стоит выдавать за другое.
Как повторить эксперимент без подгонки результата
Следующий запуск стоит начинать не с вопроса «сколько лидов угадает ИИ», а с протокола. Его можно скопировать и заполнить до показа первого объявления.
Продукт и состав предложения:
Аудитории, объявления и лид-форма:
Период и точный расход для сравнения:
Событие: отправка формы / квалифицированная заявка / продажа:
Основной прогноз: версия, дата сохранения, путь к файлу:
Основная метрика успеха и контрольный способ выбора:
Правило достаточного объёма данных:
Что не передаём модели: фактический результат и предыдущие ответы:
Когда сравниваем и какие изменения настроек фиксируем:
Как обрабатываем ноль заявок и недостаточную открутку:
Практический порядок:
- Собрать честный контекст. Не скрывать ограничения цены и комплектации. Не загружать ключи, телефоны клиентов и ненужные персональные данные.
- Развести отбор и прогноз. Сначала оценить понятность материалов, затем отдельно проверить, улучшают ли эти оценки выбор на трафике.
- Зафиксировать одну основную версию. Сохранить параметры, прогноз и критерий успеха до знакомства с результатом. Дополнительные версии показывать отдельно.
- Сравнить с простым ориентиром. Например, выбором специалиста или прогнозом по сопоставимой истории. Без базы сравнения сложно понять, добавил ли ИИ пользу.
- Сопоставить одинаковые срезы. Один период, одно событие, согласованные расходы и единая выгрузка. Если условия разошлись — явно отметить это, а не молча пересчитать факт.
- Повторить на новых запусках. Настройки, исправленные после изучения ошибки, проверять на следующей кампании, а не выдавать улучшение на старой за независимое подтверждение.
Отправка формы — только начало. В этом опыте нет подтверждённой оценки качества заявок, встреч и продаж. Для следующего этапа пригодятся сквозная аналитика и скоринг лидов: они помогают связать рекламные события с работой отдела продаж.
Что из этого стоит забрать в работу
Тестирование рекламы с ИИ уже можно рассматривать как способ упорядочить гипотезы перед запуском: проверить смысл, сопоставить обещание и форму, выбрать ограниченный набор для первого теста. В этом кейсе ранний прогноз оказался близок к общему результату, но ошибки в воронке и выборе связок показали, где методику нужно улучшать.
Перспектива — не волшебная кнопка «узнать CPL», а инструмент, который помогает внимательнее выбирать следующий эксперимент. Его ценность нужно измерять на новых кампаниях, по реальным обращениям и понятной базе сравнения.
Следите за следующими проверками
Подпишитесь на AI Marketing Lab: здесь — практические эксперименты с ИИ и маркетингом, с цифрами и разбором ограничений. Сохраните чек-лист выше и начните со своей следующей кампании: зафиксируйте прогноз до запуска, чтобы после не выбирать только удачное совпадение.